
量化研究流程
AxonX 提供研究任务的运行、记录、产物和 Studio 展示。本文使用仓库中的 plugins/a158/ 作为具体算法实现,建立从 Tushare 数据到回测结果的闭环。增强版 a158_enhanced 使用独立的 a158e_* 注册名,并增加训练特征组参数。两者共享研究阶段与基础产物形式,但跨插件复用上游前仍需检查 Task 定义、特征顺序和协议;具体用法见增强插件。
开始前确认
- 已完成快速开始,服务 token 与连接可用。
- 执行任务的服务环境已安装 a158 插件;本地 CLI 安装不会自动改变远程机器环境。
- 工作区已有覆盖训练和预测区间的 Tushare 历史数据,以及必要的主数据。
- 研究任务与上游产物位于同一工作区,或者已按任务同步准备好完整上游目录。
pip install axonx-alpha158服务已运行时,安装插件后重启服务,再运行 axonx list_installed_task_definitions 查询任务目录。预期找到 a158_etl、a158_factor、a158_train、a158_predict 和 a158_backtest。
研究链中每一步产生什么
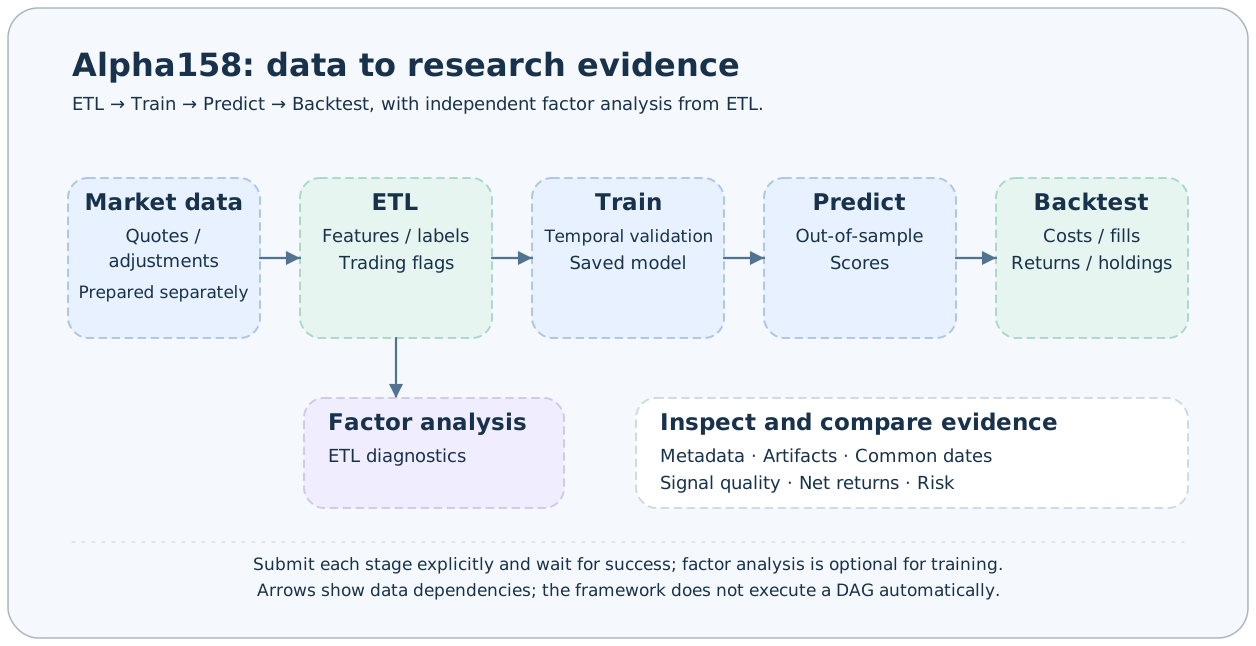
| 阶段 | 注册名 | 输入来源 | 主要结果 |
|---|---|---|---|
| 下载 | download_tushare_task | Tushare 接口 | 工作区 tushare/ 原始分区 |
| ETL | a158_etl | 原始分区与主数据 | alpha158.parquet、统计 CSV |
| 因子分析 | a158_factor | 一个 ETL Task | 因子诊断与分层收益 CSV |
| 训练 | a158_train | 一个 ETL Task | LightGBM 模型、重要性、验证历史 |
| 预测 | a158_predict | 一个 Train Task | 全截面预测 Parquet |
| 回测 | a158_backtest | 一个 Predict Task | 日频与汇总 Parquet |
因子分析是 ETL 的独立下游,训练不依赖因子分析成功。预测从训练 metadata 继续解析 ETL 上游,因此训练目录和 ETL 数据都需要保留。
提交并等待一个阶段
下面命令中的 Task ID 必须替换为上一阶段实际返回的值;不能使用注册名代替 Task ID。
axonx submit --task a158_etl --start-date 20150101返回的 answer 是 TaskHandle,保存其中 task_id 和 run_id。提交接受只表示 worker 已创建,随后等待该次执行:
axonx --client-timeout 86400 wait_task \
--task-id '<返回的 task_id>' --run-id '<返回的 run_id>'确认最终成功后,才将它传给下游。完整提交和查询方法见任务管理。不要把客户端超时解释为后台任务已经取消。
从 ETL 到样本外预测
# ETL 成功后,可独立做因子分析
axonx submit --task a158_factor --source-tasks '<ETL Task ID>'

# 训练结束日期不包含在训练区间内
axonx submit --task a158_train --source-tasks '<ETL Task ID>' \
  --train-start 20150101 --train-end 20230101 \
  --label-column label_1d_rank

# 训练成功后,预测开始日期必须不早于 train_end
axonx submit --task a158_predict --source-tasks '<Train Task ID>' \
  --pred-start 20230101 --pred-end 20231231

# 预测成功后,生成回测产物
axonx submit --task a158_backtest --source-tasks '<Predict Task ID>' \
--transaction-cost-rate 0.002每条提交命令之间都要执行上一节的等待。source_tasks 使用英文逗号分隔 Task ID;a158 各阶段要求相应类型的单个上游,不能任意添加同类型任务。
训练按交易日顺序保留末尾日期作验证,默认验证比例为 10%。先用验证集和早停选择轮数,再用训练窗口的全部有效样本拟合最终模型。保存的训练曲线来自调参阶段,不能将它当成最终模型在独立测试集上的表现。
数据范围与标签边界
ETL 默认输出从 20140101 开始的可用数据,滚动特征会读取更早的历史。下载最近 7 个自然日不能满足多年训练,更不足以生成完整滚动窗口。
a158 输出交易状态与收益标签,收益口径是买入日复权收盘到首个可卖退出日的复权收盘收益。训练和因子诊断筛选严格单日有效标签,延期退出样本与缺失标签的处理各有约束。预测保留全截面,包括不可买或缺少收益标签的行;回测再按自己的协议筛选。
默认训练目标 label_1d_rank 是截面排名标签,预测 pred 是模型评分,不能直接解释为收益率或上涨概率。
在 Studio 查看结果
各阶段的真实界面示例见结果解读:ETL、因子、训练与预测分别展示日期、指标与产物。截图来自远程工作区已有实验,不要求按本文日期得到相同数值。
依次进入 ETL、因子、训练、预测和回测页面,选中对应任务。研究列表读取成功任务的 metadata.json,运行中任务应去任务页面查看状态和日志。
阅读顺序建议是:先检查 ETL 的日期、行数和特征列,再检查训练验证信息,随后检查预测覆盖,最后解读回测协议、成本与收益。不同策略的比较见策略比较。
从运行研究链到设计实验
一次完整执行提供参数与产物;评估改进还需要控制变量、消融、筛选与独立确认。按实验设计与确认制定比较方案,再用策略比较检查共同窗口。Agent 开发增强特征的具体过程与复现入口见 Alpha158 Enhanced。
使用仓库脚本
run_pipeline.sh 已实现提交、读取 handle、逐阶段等待和失败退出,可作为串联命令的参考:
bash plugins/a158/axonx_alpha158/scripts/run_pipeline.sh脚本会安装插件、刷新最近 7 天原始数据,并使用已有历史分区跑多年研究。它不是自动补齐全量历史数据的下载脚本;执行前准备数据,并核对固定日期是否适合自己的研究区间。
常见失败与处理
| 现象 | 优先检查 |
|---|---|
| 注册名不存在 | 执行服务的插件环境与重启状态 |
| 缺少 daily、adj_factor 或主数据 | tushare/ 分区和静态文件 |
| 训练区间没有有效标签 | ETL 日期、交易状态、退出标签与训练边界 |
| 预测开始早于训练结束 | pred_start 与 metadata 的 train_end_exclusive |
| 模型校验失败 | 训练目录内 model 文件是否被替换 |
| 回测缺少字段 | 是否为匹配 a158 协议的预测产物 |
血缘图记录显式上游关系,不自动调度、补齐或重跑研究链。使用固定 task_name 重跑会替换已结束任务的目录记录;需要比较实验时使用不同名称并保留产物。