
研究产物与 Studio 展示协议
研究 Task 使用类型化 output_params 发布结果,Studio 从成功任务的 metadata.json 提取展示字段,再通过文件预览读取产物。本页区分三层要求:Python 基类必填字段、Studio 实际读取字段、具体插件的扩展协议。
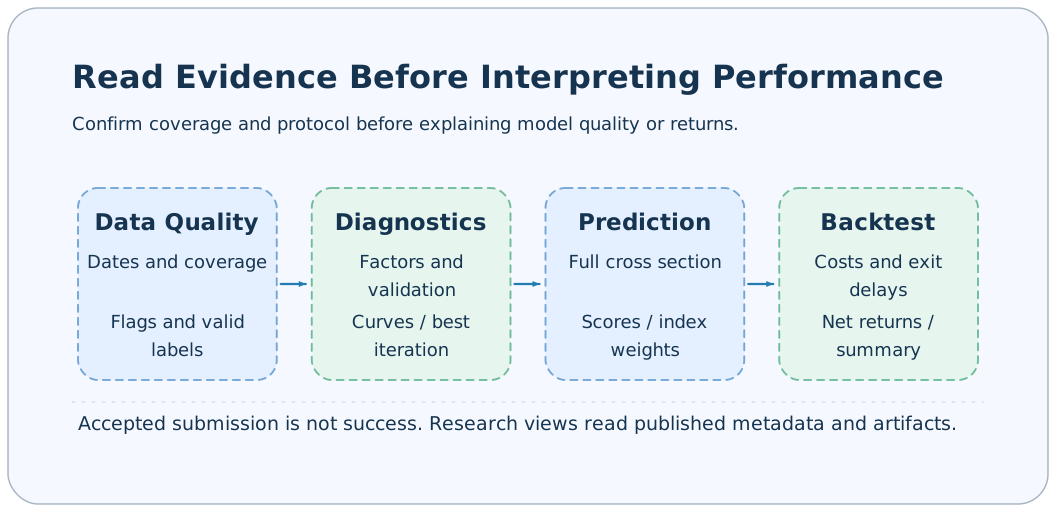
metadata 与产物映射
标准 Task 记录在 metadata 顶层保存身份、输入参数、输出参数等信息;研究字段位于 output_params,不要把它们写到顶层期待 Studio 自动识别。
以下是结构片段,不是完整 TaskMetadata:
{
  "output_params": {
    "artifacts": {
      "dataset": {
        "path": "alpha158.parquet",
        "size": 1024,
        "sha256": "0000000000000000000000000000000000000000000000000000000000000000"
      }
    }
  }
}
示例 size 和摘要只是说明字段;实际必须从生成文件计算。artifact_record(path, task_dir) 会生成相对路径、字节大小与 SHA-256。artifact_path(task_dir, metadata, name) 解析记录并拒绝绝对路径或越出任务目录的路径。
BaseOutputParams.artifacts 默认空字典,类型是 dict[str, dict[str, Any]]。因此 Python 基类没有完整校验每条 artifact 的三字段;生产者应主动调用 helper,确保页面和下游能读取。
下游 helper 解析路径本身并不自动核验所有摘要。a158 预测另行校验模型摘要,不能据此宣称所有上游数据均经过完整校验。
五类基础输出
下表的必填指模型没有默认值;不是所有字段都在 Studio 单独展示。
| 类型 | 基类必填 | 基类可选或默认字段 |
|---|---|---|
| ETL | output_file、rows、date_range | feature_columns=[]、label_columns=[] |
| Analysis | result_file、rows | scores={} |
| Train | model_file、train_rows | model_name、特征/目标列、metrics、parameters、training_curve |
| Predict | predictions_file、rows、date_range | output_columns=[]、protocol={}、statistics={} |
| Backtest | dimensions、protocol、date_range、days | 共享的 artifacts={} |
所有类型继承 BaseOutputParams;额外字段需通过输出子类声明,否则 extra=forbid 校验失败。date_range 是字符串映射,页面按 start 与 end 取值,生产者应采用这些 key。
ETL 产物
基类保存输出文件描述和列名。a158 扩展 feature_count、symbols、schema、labels、market_state 等信息,生成:
| artifact 名 | 文件 | 用途 |
|---|---|---|
dataset | alpha158.parquet | 训练、因子分析和预测的源数据 |
statistics | alpha158.csv | 各列质量统计 |
a158 下游通过 artifacts.dataset.path 解析数据,不能仅填写 output_file 而省略映射。历史字段可能保存完整字符串路径,而标准 artifact 应是 Task 目录内相对路径。
因子分析 scores
scores 的形状为“分组名 → 指标名 → 数值”:
{
  "scores": {
    "quality": { "mean_abs_ic": 0.03, "positive_ratio": 0.6 },
    "coverage": { "valid_days": 120.0 }
  }
}
这只是合法形状示例,不是 a158 的固定指标集合。Studio 动态遍历分组及指标,插件应保证指标名与定义可理解,并在详细文件或扩展定义字段交代样本、单位和计算范围。
a158 实际生成 factor_analysis.csv、factor_quantiles.csv,映射名分别为 result、quantiles,并保存 definitions、labels 等扩展字段。
训练曲线模型
TrainingCurve 是明确验证的模型:
{
  "x": ["1", "2", "3"],
  "y_left": {
    "train_l2": [0.09, 0.07, 0.06],
    "validation_l2": [0.1, 0.08, 0.085]
  },
  "y_right": {
    "validation_l1": [0.22, 0.2, 0.205]
  }
}
必须满足:
- x 是有序字符串标签,各序列按相同位置对齐。
- 每条序列长度严格等于 x 长度,数值均为有限值。
- 有 x 时至少存在一条左轴序列;右轴不能单独存在。
- 左右轴序列名称不能重复。
- 空 x 且左右组都为空表示没有曲线数据。
左轴同组应采用相近量纲和数值范围,右轴仅用于第二组尺度。协议不支持第三个数值轴。Studio 读取端只做轻量规范化;图表过滤长度不匹配的序列,计算轴范围时忽略非有限值,不会完整复验 Python 模型规则,也不会修复训练历史。生产者必须在发布前用模型验证。
a158 把 L2 放左轴、L1 放右轴;曲线是调参模型的训练/验证历史。model、feature_importance、evaluation_history 分别引用最终模型、重要性和历史 CSV。
预测统计
基类 statistics 是自由扩展映射。Studio 当前读取:
statistics.days / symbols
statistics.pred.mean / min / median / max
statistics.buyable_rows / valid_return_rows / candidate_rows
statistics.indices.<column>.constituents / days_with_weights / null_rows
缺少这些字段时页面显示空值,不意味着所有预测插件都必须提供 a158 股票统计。a158 artifact 名为 predictions,文件为 predictions.parquet。
回测需要的列是插件契约,不是 Predict 基类自动保证。a158 要求 trade_date、ts_code、name、pred、actual_return、label_valid、is_buyable、entry_is_buyable、exit_is_sellable、entry_date、exit_date、exit_delayed,并检查相关状态列是 Boolean。
回测 dimensions 与 protocol
{
  "dimensions": {
    "top_ns": [1, 5, 10, 30],
    "holding_detail_top_n": 30,
    "benchmarks": [{ "key": "universe", "label": "Universe" }]
  },
  "protocol": { "actual_return_unit": "decimal" },
  "date_range": { "start": "20230103", "end": "20231229" },
  "days": 250
}
这是基类合法结构示例。a158 提供更详细的 candidate_filter、execution、portfolio、turnover、net_return 等协议文字。页面不是自动验证协议文字的回测引擎;插件作者需明确真实执行与单位。
Studio 从 artifacts.daily.path 和 artifacts.summary.path 加载两个表,加载时每页请求 5000 行,根据 has_more 继续,直到读取完整表。仅满足 Backtest 输出模型不足以保证图表可用。
日频表的展示字段
| 字段 | 当前 Studio 用途 |
|---|---|
trade_date | 日期轴与两个策略的日期配对,采用 YYYYMMDD 字符串 |
candidate_count | 候选数量 |
ic、rank_ic | 信号曲线及移动均值 |
topN_net_return、topN_gross_return | 净复利、毛累加曲线 |
topN_turnover、topN_transaction_cost | 换手和成本观察 |
topN_ndcg | 固定展示规模的排名诊断 |
benchmark_<key>_return | dimensions 声明的基准收益曲线 |
top30_holdings | 当前固定 Top 30 明细 |
明细是结构数组,前端读取 rank、ts_code、name、prediction、daily_return、weight。a158 还保存 entry_date、exit_date、exit_delayed 供协议分析。
当前页面硬编码 top30_holdings,不会因 holding_detail_top_n 的值改变而自动寻找新列。a158 这个字段是信号目标、包含未成交候选;不能描述为实际持仓账本。
汇总表的展示字段
每行用 period_type 标明 overall、year、quarter 或 month,并提供 period、period_start、period_end、trading_days。
信号字段包括 ic_mean、icir 和 rank_ic_mean。每个 Top N 对应:
topN_net_cumulative_return
topN_net_annualized_return
topN_net_annualized_volatility
topN_net_max_drawdown
topN_net_win_rate
topN_average_turnover
topN_gross_cumulative_return
topN_gross_sharpe
topN_information_ratio_<benchmark key>
N 替换为 dimensions 中的实际数字。汇总表是插件输出;收益图和策略比较是浏览器计算。a158 毛累计汇总用复利,毛收益图用累加,口径说明见回测解读。
生产者验收
- 用实际输出子类验证 output_params。
- 先写文件,再调用 artifact_record 并发布 metadata。
- 从 Task 目录用 artifact_path 解析每个标准 artifact。
- 对照当前 Studio 字段检查日期、数值单位、布尔列和结构数组。
- 验证曲线与下游契约,保留 protocol 的明确执行说明。
不要手工用占位摘要冒充真实文件;也不要修改 metadata 来掩盖失败执行。所有图表依赖相应生产者和读取端的共同契约。