
研究结果解读
Studio 按数据处理、因子分析、模型训练、离线预测和离线回测组织成功任务的结果。每张卡片对应工作区中的 metadata 与文件产物;图表只能说明产物中的数据,需要结合插件协议解释。
本页截图展示 Studio 0.3.0 的完整英文界面,使用 Playground 合成数据。特征数量、标签、曲线和指标用于说明界面,不代表 Alpha158 基线或 README 三版本实验。解释真实结果时,以各 Task 的 metadata 和插件版本为准;下文算法说明以当前 qlib_a158 实现为准。
从运行页面进入结果页面
任务页面看执行状态、步骤和日志;研究页面看已发布的研究 metadata。任务仍在运行、失败或被取消时,优先在任务详情排障。成功任务未显示时,检查当前机器、任务类型、metadata.json 是否存在及能否被读取。
选中结果后,先核对任务身份、创建时间、来源任务和产物目录。实验比较使用具体 Task ID,固定名称重跑可能已经替换原有产物。研究列表数量不是所有已提交任务的数量。
数据处理:先判断数据是否可信
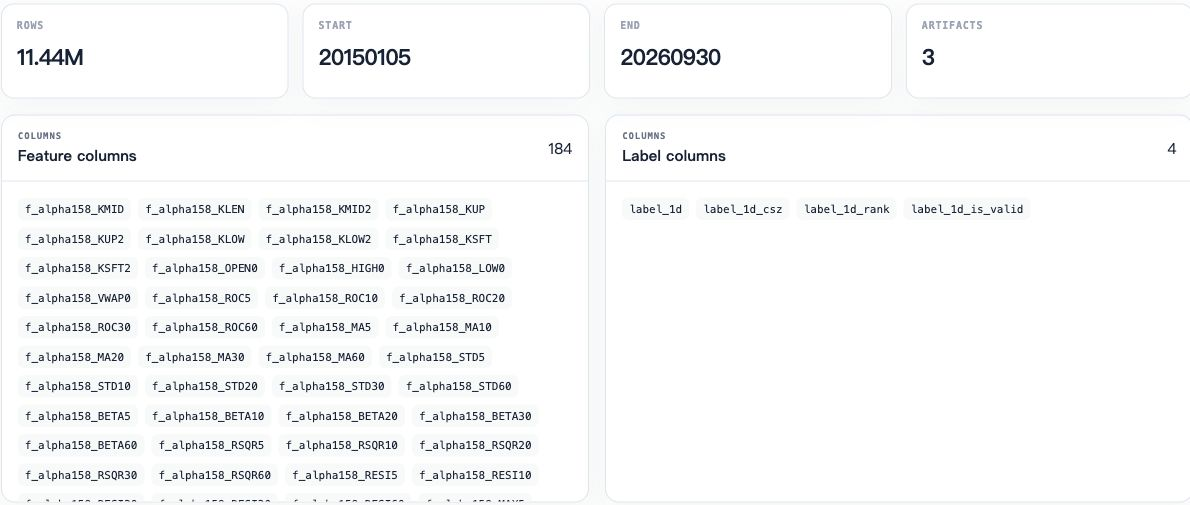
数据处理页面展示 ETL 任务生成的数据集。结果摘要将日期范围、行数和特征/标签列集中展示。先核对覆盖范围,再继续下游分析。
主要检查日期范围、行数、特征列、标签列、股票覆盖和统计文件。
| 观察项 | 应回答的问题 |
|---|---|
date_range | 是否覆盖研究目标,是否保留足够历史 |
rows 与股票数量 | 样本规模是否异常,是否只是最近几天 |
feature_columns | 模型使用的特征名称是否符合预期 |
label_columns | 独立标签产物包含哪些原始收益标签 |
| 统计 CSV | 哪些列缺失、极端值或覆盖不足 |
| 交易状态与指数权重 | 可买性、延期退出、基准是否有足够数据 |
qlib_a158 将行情对齐到交易日历,结合上市生命周期、历史名称和涨跌停信息构造交易状态;特征统计不能替代这些状态的核查。没有权重文件时,ETL 会生成空权重并记录告警,后续指数基准可能缺失。
ETL 的 statistics 文件属于插件扩展,通用基类并不强制所有 ETL 都生成同样统计。其他插件需按自己的 metadata 解读。
因子分析:关联性与稳定性
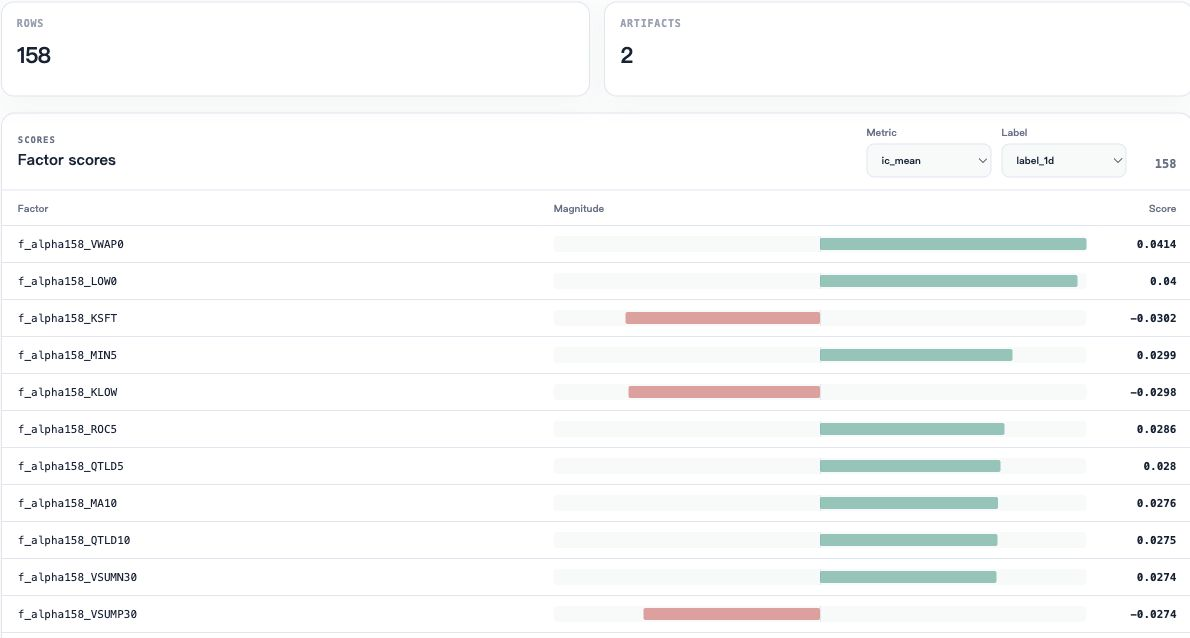
通过 Metric 与 Label 选择指标和标签;条形方向与数值共同表示因子评分。
qlib_a158 输出 factor_analysis_stats.csv 与 factor_quantiles_stats.csv。前者给出各特征的诊断结果,后者用于观察按因子值分组的收益。
默认关联独立标签产物,仅分析信号日可买且固定次一市场日收益有效的样本。调整 tradable_only、minimum_daily_samples 或 quantiles 后,结果的样本口径也会变化。
相关性符号表示方向;稳定性表示它在不同日期上的表现。不要仅用一个高分就判断因子有效,需结合每日有效样本、分组形态、缺失情况和研究时间范围。
Studio 的 scores 面板来自插件提供的“指标分组 → 数值”映射,并不是浏览器对原始数据重新计算的检验。查看 CSV 与 metadata 中的定义确认每个指标的含义。
训练:验证过程与最终模型
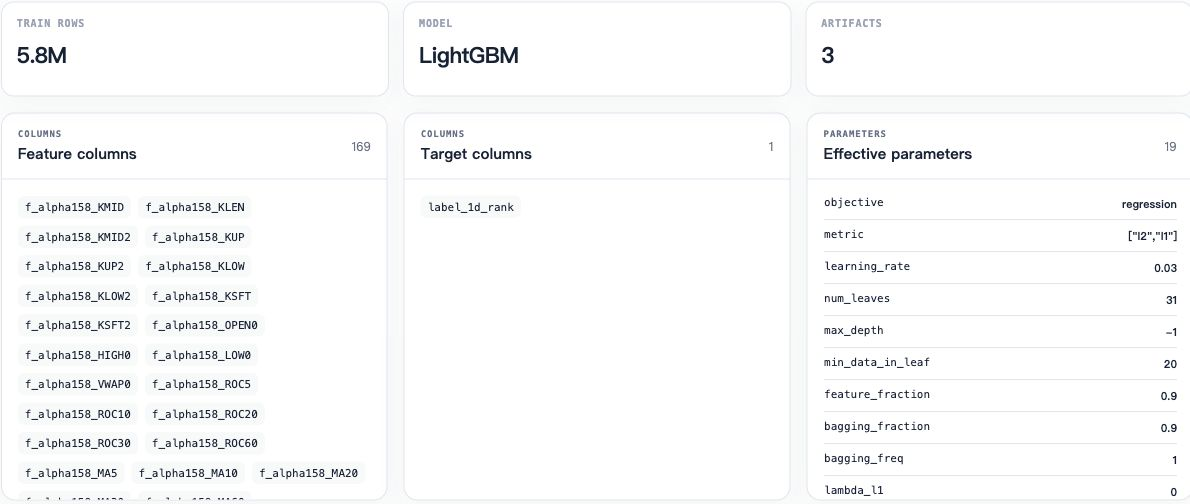
训练详情并列显示样本、特征、目标列和实际参数;这些信息用于核对实验配置。
训练结果包含模型名称、训练行数、目标列、参数、指标和训练曲线。qlib_a158 保存:
models/lightgbm_seed_<seed>_fit_end_<date>_use_<date>-onward.txt:按最佳轮数拟合的最终模型。feature_importance_stats.csv:gain 与 split 两种重要性。metadata.json.output_params.model_groups:模型配置、使用日期、参数、指标和训练/验证曲线。
qlib_a158 的训练窗口左闭右开,末尾日期保留作验证。调参阶段选择最佳迭代轮数,然后使用训练窗口内全部有效样本重新拟合。曲线与验证指标来自选择轮数的模型,不是最终模型的独立样本外评估。
如何读训练曲线
上方完整训练截图同时展示摘要与曲线。Playground 的合成 train 和 validation 序列均使用左轴。查看实际 Task 时,应核对图例和轴标签;插件可以发布使用不同量纲的左右轴序列。
training_curve.x 的每个位置对应一次迭代或一个有序时间点。所有序列共享同一 x;左轴与右轴允许两组不同量纲。不能只看两条视觉上靠近的线就比较数值大小,应先看轴和指标单位。
当前 qlib_a158 的 L2 序列放左轴,L1 序列放右轴。训练误差持续下降而验证误差停止改善时,结合早停轮数与最佳轮数检查;曲线最后一轮不一定等于保存模型的迭代数。
空曲线表示没有可用训练点。图表会过滤长度不匹配的序列,并在计算轴范围时忽略非有限值;读取端不替代 Python 模型的完整校验。产物格式见研究产物协议。
如何读特征重要性
gain 是分裂带来的累计增益,split 是参与分裂的次数。高重要性不等于因果关系,也不等于单因子收益稳定;高度相关特征会分摊重要性。结合因子分析和样本外预测看结果。
预测:评分与覆盖
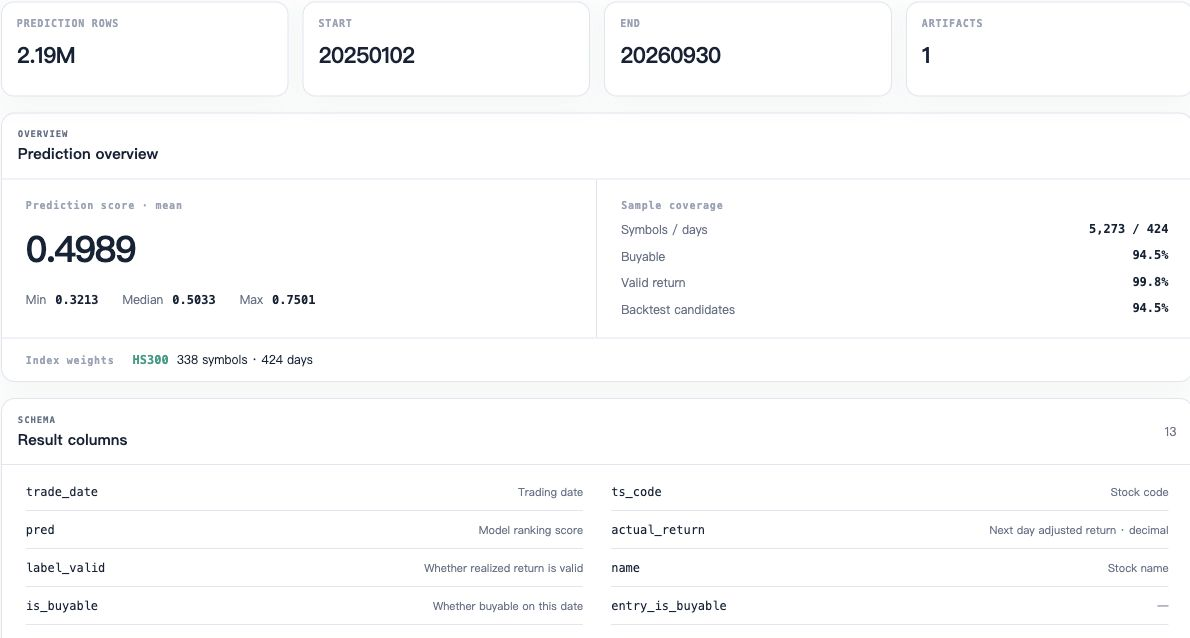
预测概览展示评分分布、样本覆盖与输出字段。截图中的评分属于该次模型,不代表收益概率。
qlib_a158 保存完整预测截面,包含不可买或没有指数权重的样本;预测不依赖未来标签。Studio 展示预测行数、日期、股票数、评分范围、可买行数和指数覆盖等统计。
| 统计项 | 解读 |
|---|---|
rows、days、symbols | 预测文件总体规模 |
pred.mean/min/median/max | 模型输出分布,单位由训练目标决定 |
buyable_rows | 信号日满足可买标志的行 |
candidate_rows | 插件统计中的可买候选规模 |
indices.* | 成分覆盖、权重覆盖日期、缺失行数 |
默认训练目标是截面收益排名,pred 是评分,既不是收益率也不是概率。不同目标或不同训练插件的评分尺度可能不同,直接比较分数绝对值通常没有共同含义。
candidate_rows 并不保证最终回测中每行都成交:回测可能限制指数范围,资金被旧仓占用,或 entry 可买代理不通过。应继续查看回测协议和未成交统计。
产物与可追溯性
在结果页点击产物可预览或定位文件。标准 artifacts 中路径以当前 Task 目录为基准,size 是字节数,revision 是生成时文件大小与纳秒修改时间的组合。
不要直接修改已成功任务的模型或数据文件;它会使 metadata 的校验信息与实际内容分离。qlib_a158 预测会校验训练模型摘要,并检查模型特征名称与顺序。
对于异常结果,保留 Task ID、started_at、输入参数、上游 ID、metadata 和日志。用任务血缘核对依赖,再检查文件内容。